実践チュートリアル
ウェブサイトのリンク切れをチェックする方法
ウェブサイトのリンク切れをチェックする方法をご紹介します。管理されたクロールから始め、失敗した各URLを確認し、実際のリンク切れと一時的なアクセス問題を切り分けます。このチュートリアルでは、内部ページ、外部参照、画像、ドキュメントを対象に、繰り返し実行できるリンク切れチェッカーのワークフローを説明します。
スキャンする前に
前提条件
信頼性の高いリンク切れチェッカーの確認は、明確な範囲、クロール可能な開始地点、そして単にエラーを収集するのではなく判断を記録する方法から始まります。
ワークフロー
番号付きの手順
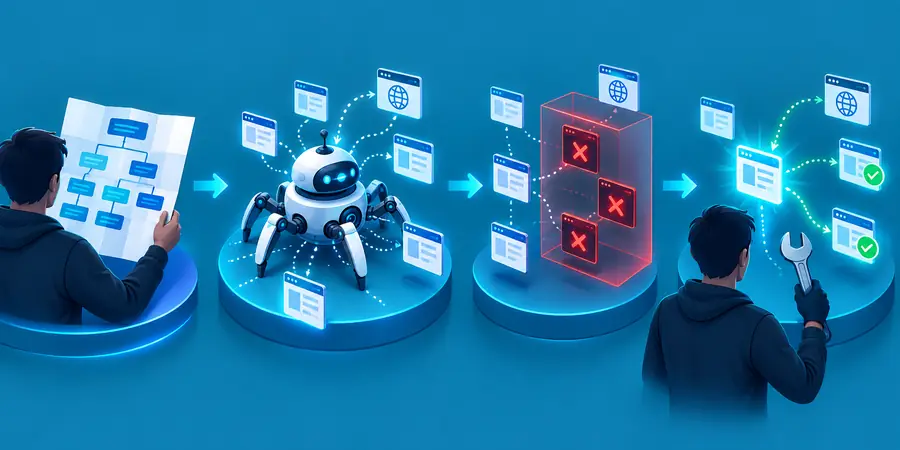
広範なクロールから具体的な修正へと進めます。範囲を一貫して保てば、小規模な案内サイトでも大規模なコンテンツライブラリでも、同じ手順を利用できます。
-
1
クロール範囲を定義する
正規のホームページまたは代表的なセクションを開始URLとして選択します。チェックに内部リンクのみ、外部リンク、画像、ダウンロード可能なファイル、または検出可能なすべてのリンク先を含めるか決定します。日付、サイトのバージョン、ステージング用パスや非公開のアカウントページなど、意図的に除外した領域を記録します。
-
2
リンクチェックを実行する
クロールを開始し、リンク切れチェッカーに選択した範囲内のページをたどらせます。フラグが付いた結果ごとに、ソースページ、リンク先URL、レスポンスステータス、リダイレクトチェーン、アンカーテキストを確認します。リクエストのタイムアウトやボットのブロックは調査の手がかりであり、リンク先が恒久的に消失した証拠ではありません。
-
3
検証、修正、再テストを行う
重要なエラーを手動で開き、URLの更新、リソースの置き換え、古くなった文言の削除、自サイトでの適切なリダイレクトの追加など、正確で最小限の修正を選択します。変更を保存し、対象ページをもう一度チェックして、修正が機能したと推測するのではなく、レポートで修正を確認します。
レポートを確認する
よくあるエラーと修正方法
有用なレポートは、実際のリンク切れと、リクエストが中断、リダイレクト、拒否された、または移行先サーバーで異なる解釈をされたケースを区別します。
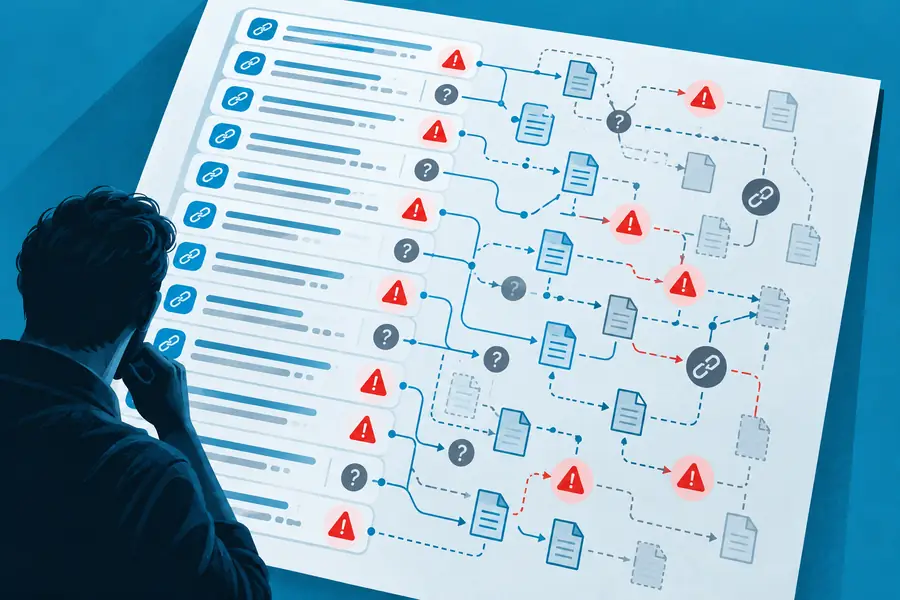
失敗したリクエストについては、ページを編集する前に状況を確認する必要があります。
検証前検証後限界を理解する
高度なヒント
基本的なクロールが安定したら、状況に応じた情報を追加し、訪問者を優先し、適切な間隔でチェックを繰り返すことで、結果の品質を高めましょう。
ステータスコードだけでは全体像はわかりません
200レスポンスでも、空のページ、関連性のないページ、アクセス拒否の状態につながる場合があります。一方、一時的な5xxレスポンスは、次のリクエストで回復する可能性があります。
代わりに行うこと
重要度の高い移行先を手動で開き、HTTPステータスとともに、実際に表示されたページタイトル、コンテンツ、ユーザーの結果を記録します。
クローラーがすべてのURLを検出できるとは限りません
JavaScriptによるナビゲーション、フォームで生成されるリンク、robotsルール、認証によるアクセス制限、遅延読み込みコンテンツによって、移行先が通常のクロールの対象外になることがあります。
代わりに行うこと
重要なテンプレートとナビゲーション経路を個別に調査し、認証が必要な領域やインタラクティブな領域は、適切なアクセス権でテストします。
外部サイトは予告なく変更される可能性があります
自分の参照先は修正できますが、別のドメインが後から移転したり、リクエストをブロックしたり、コンテンツを削除したりするかどうかを制御することはできません。
代わりに行うこと
信頼性の高い安定した情報源を優先し、不要な深い階層へのリンクを避け、継続的にアクセスされるページには定期的なチェックを設定します。
リダイレクトによって意図が維持される場合もあれば、弱まる場合もあります
すべてのリダイレクトを置き換える必要はありませんが、長いチェーン、ループ、または関連性のないコンテンツへのリダイレクトは、質の低いユーザー体験を生み、元の文脈を損なう可能性があります。
代わりに行うこと
可能な場合は移行先への直接リンクを維持し、最終ページがアンカーテキストと一致することを確認してから、テンプレート全体に広がる前にループを削除します。
記録を残す
記録すべき情報
リンク切れチェッカーのレポートは、各検出結果に、別の人が再現、優先順位付け、修正確認を行うのに十分な情報が含まれていると、より役立つものになります。
- リンクが表示されているページ
- 01 ソース
- リクエストされたURL
- 02 遷移先
- 確認されたレスポンスまたはエラー
- 03 ステータス
- 修正、置換、またはレビューの判断
- 04 対応
次回チェック
主要なコンテンツの公開、移行、ナビゲーションの変更、またはドメインの更新後に、対象を絞ったリンク切れチェッカーのレビューを実行します。まずは訪問者にとって最も重要なページから確認し、確認済みの例外を記録して、タスクを完了する前に修正したURLを再テストします。誰も検証できない大規模なレポートよりも、短時間で定期的に行うレビューのほうが信頼しやすくなります。
簡単な回答
チュートリアルFAQ
これらの回答では、公開中のウェブサイトでリンクをチェックする際によく発生する実務上の判断について説明します。
サイトの開始URLをリンク切れチェッカーまたはクローラーに入力し、選択した範囲内のページとリンクされたリソースを検出させます。フラグが付いた各URLを文脈の中で確認し、問題が恒久的なものかどうかを検証して、ソースページまたは遷移先を修正し、フォローアップチェックを実行します。
ソースページ、正確な遷移先URL、レスポンスステータス、リダイレクトチェーンを確認します。次に、通常のブラウザーセッションで遷移先を開いてください。一時的な障害、ボットの制限、または認証要件によって、誤解を招くエラーが発生する可能性があるためです。
いいえ。まず、その参照先が今も役立つか、またエラーが一時的なものか、アクセス環境に固有のものかを判断してください。現在も利用できる信頼性の高い情報源がある場合は置き換え、周辺のコンテンツでその参照が不要になった場合にのみリンクを削除します。
サイトのリニューアル、移行、URLの変更、大規模なコンテンツ編集、ナビゲーションやホスティングの変更後にチェックを実行してください。運用中のサイトでは、月次または四半期ごとの定期的な確認で外部リンクの変化を検出できます。また、重要なランディングページは更新のたびにチェックするのが望ましいです。
必ずしもできるとは限りません。標準的なクローラーでは、スクリプトの実行後に生成されるリンク、フォームの背後に隠れたコンテンツ、認証が必要なページを見落とすことがあります。重要なインタラクティブな導線は別途確認し、適切な場合は非公開エリアへのアクセス権限を持つクロール設定を使用してください。